1. n8n 與 AI 自動化架構簡介
n8n 是一款功能強大的開源工作流自動化平台(Workflow Automation Tool)。在結合本地 AI 部署(如 Ollama、Qdrant 向量資料庫、ComfyUI 等)後,n8n 可以轉型為自動化 AI Agent(AI 代理)系統。
為了讓工作流流暢運作,AI 電腦架構可分為兩大核心:
-
n8n 邏輯與資料庫層:負責流程調度、資料轉換與 HTTP 請求處理。本身對 CPU/RAM 需求溫和。
-
AI 推理與模型運算層:負責執行大語言模型(LLM)、文字嵌入(Embeddings)或圖像生成。此部分非常依賴顯示卡顯存(VRAM)與系統記憶體(RAM)。
2. 系統需求與硬體配置等級
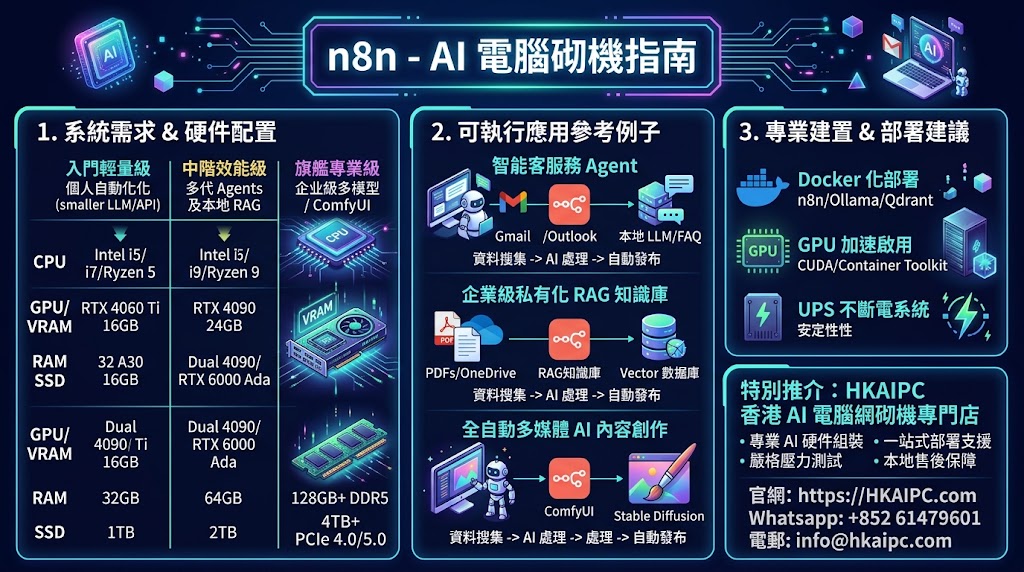
建置專屬 n8n AI 電腦時,主要考量為欲運行的 AI 模型規模與並發量。以下提供三個不同階級的硬件建議配置:
硬件配置對比表
| 硬件組件 | 入門輕量級(中小企/個人自動化) | 中階效能級(多 Agent / 本地 RAG) | 旗艦專業級(企業級/多模型並行) |
| 目標場景 | n8n + API / 小型本地 LLM (7B-8B) | 7B-14B LLM 本地推理 + RAG 知識庫 | 32B-70B LLM + 多模態生圖 (ComfyUI) |
| CPU | Intel Core i5 / AMD Ryzen 5 (6核+) | Intel Core i7 / AMD Ryzen 7 (8核+) | Intel Core i9 / AMD Ryzen 9 / Threadripper |
| 顯示卡 (GPU) | NVIDIA RTX 4060 Ti (16GB VRAM) | NVIDIA RTX 4090 (24GB VRAM) | 雙卡 RTX 4090 (48GB) 或 RTX 6000 Ada |
| 系統記憶體 (RAM) | 32GB DDR5 | 64GB DDR5 | 128GB DDR5 (支持高容量數據處理) |
| 儲存空間 (SSD) | 1TB PCIe 4.0 NVMe SSD | 2TB PCIe 4.0 NVMe SSD | 4TB+ PCIe 4.0/5.0 NVMe SSD (RAID 0/1) |
| 電源供應器 (PSU) | 650W - 750W 80 Plus Gold | 1000W 80 Plus Gold / Platinum | 1300W - 1600W 80 Plus Platinum |
| 散熱系統 | 風冷(雙塔) | 360mm 一體式水冷 | 360mm / 420mm 高效水冷 |
硬件挑選核心考量
-
顯示卡 (GPU / VRAM):AI 電腦最關鍵的組件。LLM 與圖像模型直接載入至 VRAM 中。若要流暢運行本地 AI Agent 與長文本(Context Window),建議顯存起步為 16GB,最佳體驗為 24GB 或以上。
-
系統記憶體 (RAM):n8n 及 Docker 容器、向量資料庫(如 Qdrant、PostgreSQL)運行需要足夠的物理記憶體。32GB 為基本配置,64GB 以上能確保載入較大型資料庫時不會崩潰。
-
高速 SSD:模型檔案(如 GGUF、Safetensors)通常達數 GB 至數十 GB,高讀寫速度(7000 MB/s+)可大幅縮短模型載入與切換的時間。
3. 可執行的 n8n + AI 應用參考例子
擁有高性能的本地 AI 電腦後,您可以在 n8n 中構建多種自動化流程:
例子一:智能客戶服務與自動 Email 回覆 Agent
-
工作流程:n8n 監聽 Gmail/Outlook 收件箱 $ ightarrow$ 提取郵件內容 $ ightarrow$ 調用本地 Ollama (如 Qwen 8B) 進行意圖分析與分類 $ ightarrow$ 透過 RAG (向量資料庫) 搜尋公司產品 FAQ $ ightarrow$ 自動生成精準回覆草稿並發送。
-
硬件要求:入門級即可順暢運行。
例子二:企業級私有化 RAG 知識庫與文件分析系統
-
工作流程:監控指定資料夾/OneDrive $ ightarrow$ 自動讀取 PDF、Word、Excel 文件 $ ightarrow$ 將文本向量化(Embedding)存入本地 Qdrant 向量資料庫 $ ightarrow$ 當員工在 Slack/Teams 提問時,n8n 檢索相關文件並交由本地 LLM 總結回答。
-
優點:敏感商業數據完全留在本地電腦,不上傳至公有雲端,滿足數據安全規管。
-
硬件要求:中階效能級(需要足夠的 RAM 與 VRAM 處理大量向量比對)。
例子三:全自動多媒體 AI 內容創作管線 (Text-to-Image / Video)
-
工作流程:n8n 捕捉 RSS 訂閱或社群熱點 $ ightarrow$ LLM 生成文案與提示詞(Prompts) $ ightarrow$ 透過 API 觸發本地 ComfyUI / Stable Diffusion 生成高畫質配圖/宣傳海報 $ ightarrow$ 自動排程發布至 Instagram、LinkedIn 及 Facebook。
-
硬件要求:中階至旗艦級(高畫質 AI 生圖對 GPU 算力及 VRAM 要求極高)。
4. 專業建置與系統部署建議
在砌機與安裝軟體環境時,建議遵循以下部署規範:
-
環境隔離(Docker 化):採用 Docker Compose 部署 n8n、Ollama、Qdrant 及 PostgreSQL。如此能方便管理各服務的資源分配與備份。
-
GPU 加速啟用:安裝最新的 NVIDIA CUDA Toolkit 與 Container Toolkit,確保 Docker 容器能直接調用顯示卡的 Tensor Cores 進行硬件加速。
-
不斷電系統(UPS):作為自動化伺服器,建議配備 UPS 不斷電系統,避免突發停電導致工作流中斷或資料庫損壞。
5. 特別推介:HKAIPC 香港 AI 電腦砌機專門店
建置一台能夠高效且穩定運行 n8n AI 自動化工作流的電腦,從硬件搭配、VRAM 容量調配到軟體環境(Docker、CUDA、Ollama)的優化,都需要豐富的專業知識。
如果您希望打造無縫運行的 n8n AI 自動化工作站,特別推介 「HKAIPC 香港AI電腦砌機專門店」!
告訴我們模型、軟件、用途及預算,我們可以按工作流整理 AI PC 配置方向。
查詢 AI 配機 →