Open WebUI 是目前最受歡迎的自託管(Self-Hosted)AI 平台介面,具備與 ChatGPT 相似的直覺式操作體驗,並支援權限管理、多模型切換、RAG(檢索增強生成文件問答)、圖像生成(ComfyUI/Stable Diffusion)及網頁搜尋等功能。
要打造一套能順暢執行 Open WebUI 及本地大語言模型(LLM,如 Llama 3、Qwen 2.5、DeepSeek 等)的 AI 電腦,硬體配搭的核心在於 顯存(VRAM) 與 系統記憶體(RAM)。
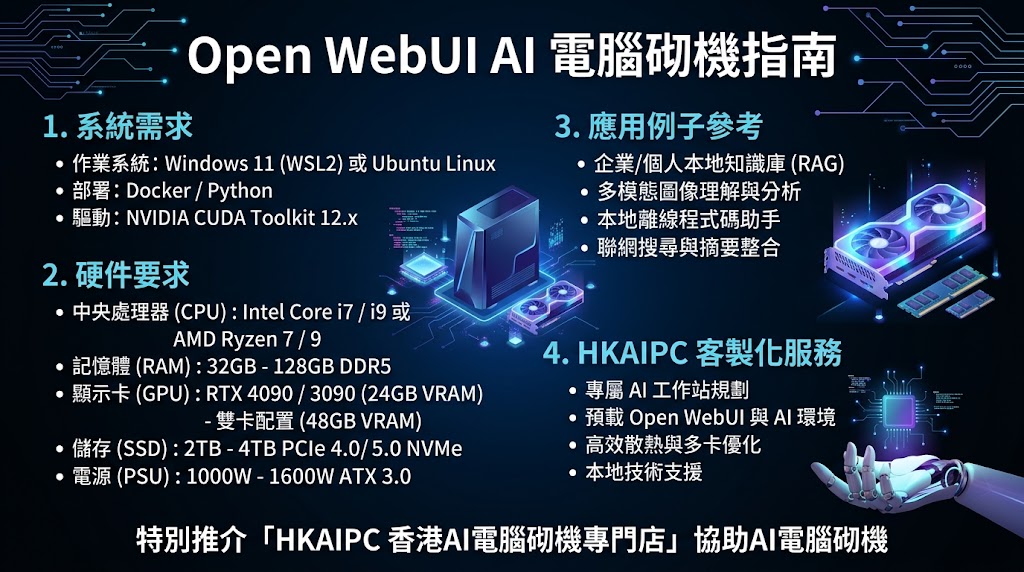
1. 系統需求與運行環境
Open WebUI 本身採用輕量化的輕量前端與 FastAPI 後端,底層模型推論通常搭配 Ollama 或 vLLM 引擎。
-
作業系統:Windows 11 (需啟用 WSL2) 或 Ubuntu Linux 22.04 / 24.04 LTS(推薦 Linux / WSL2 環境,顯存調配效率最佳)。
-
部署方式:Docker / Docker Compose (官方推薦) 或 Python venv 直接運行。
-
核心驅動:NVIDIA CUDA Toolkit 12.x 及 NVIDIA Driver (550+)。
2. 硬體架構配置指南
(1) 顯示卡(GPU)— AI 電腦的最核心
大語言模型的推理速度完全取決於 GPU 算力與 VRAM 容量。顯示記憶體(VRAM)決定了你能運行多大規格的模型。
| 需求層級 | 建議 GPU | 顯存 (VRAM) | 可流暢運行的模型規格(4-bit / 8-bit 量化) |
| 入門體驗 | RTX 3060 12GB / RTX 4060 Ti 16GB | 12GB - 16GB | 7B - 8B 模型(如 Llama-3.1-8B、Qwen2.5-7B) |
| 進階實用 | RTX 4090 24GB / RTX 3090 24GB | 24GB | 14B - 32B 模型(如 Qwen2.5-32B、Gemma-2-27B) |
| 專業/企業級 | 雙 RTX 3090 / 雙 RTX 4090 (48GB) | 48GB | 70B 模型量化版(如 Llama-3.3-70B Q4) |
(2) 主記憶體(RAM)
-
最低要求:32GB DDR4 / DDR5。
-
建議配置:64GB - 128GB DDR5。
-
解析:當模型容量超出 GPU VRAM 時,系統會將部分模型層卸載(Offload)至主記憶體,記憶體容量與頻寬(如雙通道/四通道 DDR5)會直接影響溢出時的運行速度。
(3) 中央處理器(CPU)
-
建議配置:Intel Core i7 / i9 (13/14代/15代) 或 AMD Ryzen 7 / 9 (7000/9000 系列)。
-
解析:主要負責 Open WebUI 的背景任務、向量資料庫(Vector DB)運算、PDF/Docx 文件解析及數據預處理。
(4) 儲存空間(SSD)
-
建議配置:2TB - 4TB PCIe 4.0/5.0 NVMe M.2 SSD。
-
解析:模型檔案體積龐大(單個 32B 模型約 20GB-30GB,70B 模型約 40GB+),高讀寫速度的 NVMe SSD 能大幅縮短載入模型至 VRAM 的時間。
(5) 電源與散熱 (PSU & Cooling)
-
電源:單卡 RTX 4090 建議 850W-1000W ATX 3.0 電源;雙卡(Dual GPU)建議 1300W - 1600W 高品質電源。
-
散熱與機箱:AI 長時間高負載推理會產生大量熱能,機箱需具備良好風道,CPU 建議配置 360mm 水冷,GPU 間需保留足夠散熱間隙。
3. 可執行的應用案例與實戰範例
搭建好 Open WebUI 後,您可以實現以下強大的本地 AI 應用:
-
企業/個人知識庫問答 (RAG - 檢索增強生成)
-
應用:上傳 PDF、Word、Excel 或 Markdown 格式的內部文件或合約。
-
效果:AI 會在本地將文件轉換為向量數據,並基於這些文件精準回答問題、總結報告,數據 100% 不會外洩。
-
-
多模態圖像理解與 AI 生態整合
-
應用:結合多模態模型(如 Qwen2-VL、Llama-3.2-Vision)。
-
效果:可以直接上傳圖片、截圖、流程圖或圖表,讓 AI 自動辨識內容、提取文字或進行數據分析。
-
-
本地離線程式碼助手
-
應用:搭配 CodeLlama、Qwen2.5-Coder 等程式碼專用模型。
-
效果:協助工程師編寫、重構、檢查 Code 中的 Bug,實現離線極速 Auto-completion。
-
-
Web 聯網搜尋與摘要整合
-
應用:Open WebUI 內建支援整合 SearXNG、Brave Search 等搜尋引擎。
-
效果:讓本地 AI 模型具備即時網頁搜尋能力,回答最新資訊並附帶參考來源。
-
4. AI 砌機方案推薦範例(無需考慮預算下的典型配置)
| 硬件組件 | 進階單卡 AI 繪圖與語言模型配置 | 頂級雙卡 70B 模型研發配置 |
| CPU | Intel Core i7 / AMD Ryzen 7 | Intel Core i9 / AMD Ryzen 9 |
| GPU | NVIDIA GeForce RTX 4090 24GB | NVIDIA RTX 4090 24GB x 2 (總計 48GB VRAM) |
| RAM | 64GB DDR5 (32GB x 2) | 128GB DDR5 (64GB x 2 / 32GB x 4) |
| SSD | 2TB PCIe 4.0 NVMe SSD | 4TB PCIe 4.0 / 5.0 NVMe SSD |
| PSU | 1000W ATX 3.0 電源 | 1600W Titanium 級電源 |
| 主板 | Z790 / X670 主機板 | 支援 PCIe 雙槽 X16/X8 拆分之高階主機板 |
特別推介:HKAIPC 香港 AI 電腦砌機專門店
想擁有專屬於您的本地 Open WebUI 系統,卻不知如何挑選相容的硬體或設定複雜的 CUDA 與 Docker 環境?
「HKAIPC 香港AI電腦砌機專門店」 提供一站式 AI 電腦客製化與搭建服務:
-
專業硬體匹配:根據您想運行的 AI 模型規模(7B、32B 或 70B+),為您精準規劃 GPU 顯存與系統效能的最佳組合。
-
預載 Open WebUI 與 AI 環境:出貨即完成 Docker、Ollama、vLLM、CUDA 驅動及 Open WebUI 系統配置,開機即可直接開啓瀏覽器使用。
-
散熱與多卡風道優化:針對深度學習高負載運算,提供專業水冷與風道設計,確保系統長時間運行穩定不過熱。
-
在地技術支援:提供專業售後服務與本地 AI 軟體安裝指導,讓您無縫踏入私有化 AI 的全新時代!
歡迎聯絡 HKAIPC 香港AI電腦砌機專門店,由我們的專家團隊為您量身打造最強本地 AI 工作站!
告訴我們模型、軟件、用途及預算,我們可以按工作流整理 AI PC 配置方向。
查詢 AI 配機 →