AnythingLLM 是一款強大且極具私密性的全功能 AI RAG(檢索增強生成)應用桌面客戶端。它能將企業文件、PDF、網頁與數據庫進行向量化(Vector Embedding),並結合本地大語言模型(LLM)進行精準問答與文檔分析。
要順暢運行 AnythingLLM 並實現流暢的本地 AI 算力,配置一部針對 AI 運算優化的電腦(AI PC)至關重要。
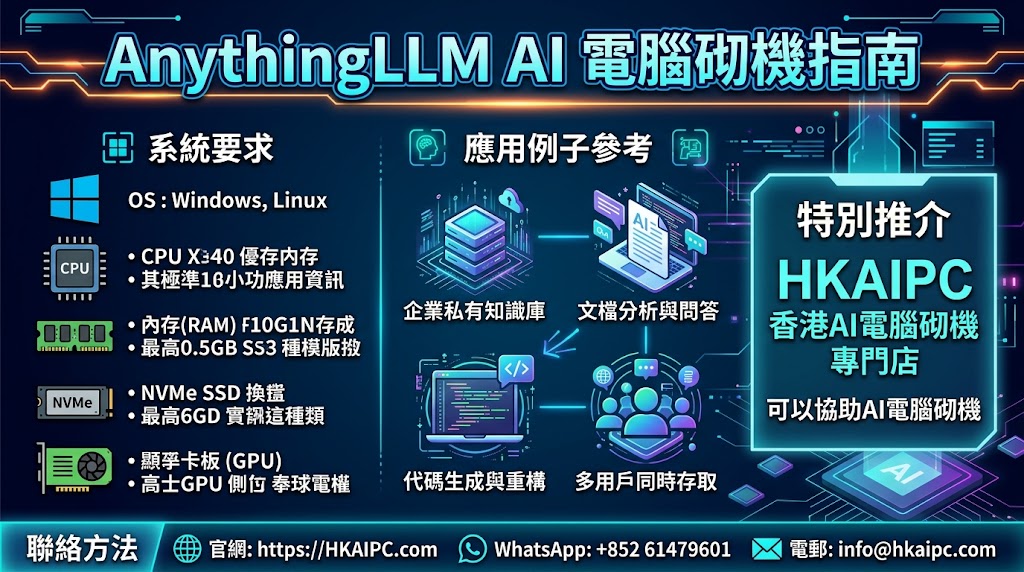
一、 系統與軟件需求
-
操作系統:Windows 11 (64-bit) / Ubuntu Linux 22.04 LTS 或以上
-
核心依賴:
-
Ollama / LM Studio:作為本地 LLM 的推理引擎與後端(AnythingLLM 原生支援內置或外掛)
-
CUDA Toolkit & cuDNN:NVIDIA 顯卡加速必備驅動
-
-
環境要求:主板需開啟 XMP/EXPO 記憶體超頻,並在 BIOS 中開啟 ReBAR (Resizable BAR) 以最大化 GPU 顯存吞吐量
二、 硬件要求與選型建議
AnythingLLM 的運算主要分為兩部分:文檔向量化處理(Embedding)與 大模型推理(LLM Generation)。硬件選擇直接決定了回答速度與可處理的文件規模。
1. 顯示卡 (GPU) —— 核心決定因素
GPU 的 顯存容量 (VRAM) 與 顯存頻寬 是決定能否運行大模型及回答速度的最關鍵指標。
-
入門級 (7B/8B 模型):NVIDIA RTX 4060 Ti (16GB) / RTX 3060 (12GB)
-
可順暢運行 Llama 3 8B、Qwen 2.5 7B 等量化模型。
-
-
進階中階 (14B ~ 32B 模型):NVIDIA RTX 4070 Ti Super (16GB) / RTX 4080 Super (16GB)
-
適合處理複雜文件推理、寫作與長文本理解。
-
-
專業旗艦 (70B / DeepSeek 蒸餾模型):NVIDIA RTX 4090 (24GB) 或 雙 GPU 組合(如 2× RTX 4090 / 2× RTX 4070Ti Super)
-
滿足高精確度、大上下文(Context Window)及多用戶同時存取的 RAG 需求。
-
2. 中央處理器 (CPU)
主要負責數據預處理、向量數據庫檢索(Vector Search)及系統調度。
-
推薦:Intel Core i7-14700K / AMD Ryzen 7 7800X3D 或 Ryzen 9 7900X 以上
-
要求:需支援 AVX2 / AVX-512 指令集,確保向量運算效率。
3. 系統記憶體 (RAM)
-
最低要求:32GB DDR5
-
推薦配置:64GB ~ 128GB DDR5
-
作用:當 GPU VRAM 溢出時,系統需要依靠 RAM 進行 CPU 輔助推理;此外,載入大型向量數據庫(如 LanceDB、Chroma)亦極度消耗記憶體。
4. 儲存空間 (SSD Storage)
-
推薦配置:2TB 或以上 PCIe 4.0/5.0 NVMe M.2 SSD(讀取速度 5000MB/s 以上)
-
需求理由:
-
單個 7B-70B 的 GGUF 模型檔案約佔 5GB ~ 40GB 不等。
-
向量化的本地知識庫(Vector Database)需要極高的隨機讀寫速度以實現毫秒級檢索。
-
5. 電源與散熱 (PSU & Cooling)
-
電源:建議 850W - 1200W(80 PLUS Gold/Platinum 認證),確保 GPU 長時間滿載運算時穩定供電。
-
散熱:360mm 水冷散熱器 + 高風量機箱,防止長時間 LLM 生成過程因過熱降頻。
三、 可執行的應用參考例子
配置好 AnythingLLM AI 電腦後,即可實現 100% 本地離線運行 的多種強大應用:
1. 企業/個人私有文檔智庫 (RAG 知識庫)
-
應用場景:匯入數百份 PDF 合約、公司政策、財務報表或工程圖紙說明書。
-
執行效果:直接詢問「根據2024年財務報表,第三季度的研發支出是多少?」,AnythingLLM 會在數秒內給出準確答案,並附帶引用原文頁碼。
2. 代碼庫理解與技術文檔助理
-
應用場景:將整個軟件項目的 Codebase (Python, C++, JavaScript) 或 API 文檔導入。
-
執行效果:協助工程師快速定位 Bug 邏輯、重構代碼或生成 API 調用範例,無需擔心核心代碼洩漏至外網。
3. 智能客戶服務與自動化問答 Agent
-
應用場景:結合 AnythingLLM 的 Web Scraper 功能,抓取官網 FAQ 及產品頁面。
-
執行效果:建構本地 AI 客服助手,精確解答客戶關於產品規格與售後流程的查詢。
4. 學術研究與文獻整理
-
應用場景:一次性上載數十篇英文學術論文。
-
執行效果:跨論文進行對比分析、生成摘要,並以中文梳理各篇論文的研究方法與結論差異。
特別推介:HKAIPC 香港AI電腦砌機專門店
想要打造最佳的 AnythingLLM 本地 AI 算力平台,但對硬件搭配、GPU 顯存調優及 CUDA 環境設定無從下手?
「HKAIPC 香港AI電腦砌機專門店」 提供一站式專業 AI 電腦組裝與調優服務:
-
專業 AI 硬件匹配:根據你的 RAG 知識庫規模與目標模型(7B / 14B / 70B),量身定制最合適的 CPU、GPU 顯存及記憶體組合。
-
預裝與優化服務:提供一站式部署服務,預先安裝及調優 AnythingLLM、Ollama、CUDA 環境與常用本地大模型,開機即用。
-
雙 GPU / 工作站級組裝經驗:具備豐富的大顯存、雙顯卡水冷工作站組裝與散熱優化經驗,確保 AI 運算長久穩定。
歡迎聯絡 HKAIPC 香港AI電腦砌機專門店,讓我們的專業團隊為你量身打造專屬的 AI 本地算力中心!
告訴我們模型、軟件、用途及預算,我們可以按工作流整理 AI PC 配置方向。
查詢 AI 配機 →