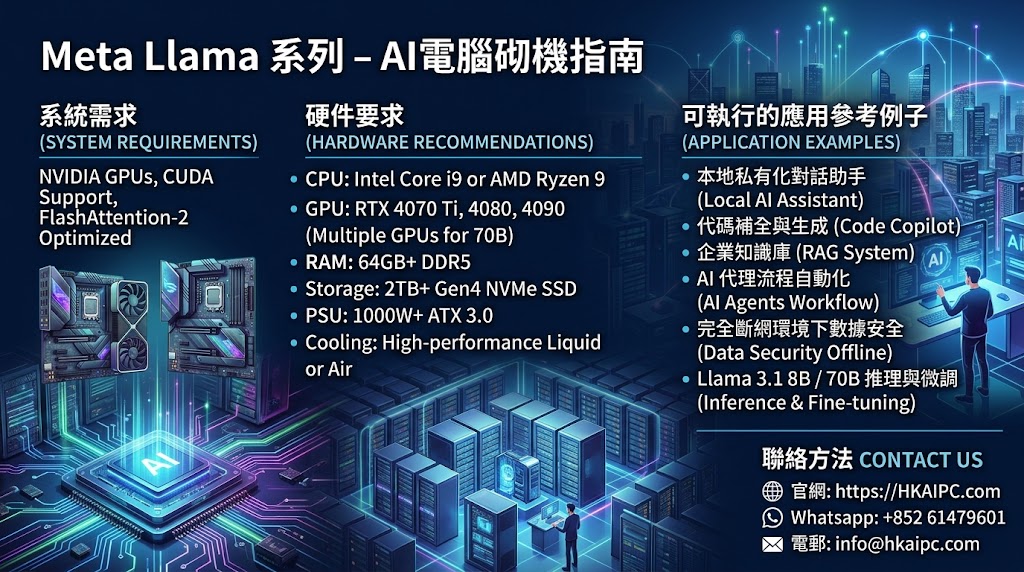
針對運行 Meta Llama 系列(Llama 3.1 / 3.2 / 3.3 等)開源大語言模型的硬體需求,AI 電腦的砌機規格主要取決於 模型參數規模(7B / 8B / 70B / 405B) 以及 量化精度(FP16 / Q8 / Q4)。
顯存(VRAM)是 AI 運算的絕對核心,其次是系統記憶體(RAM)與 PCIe 傳輸頻寬。
1. Llama 模型規格與顯存需求矩陣
執行 LLM 的基本顯存計算公式:
$$ ext{顯存需求 (GB)} approx left( ext{參數量 (Billion)} imes frac{ ext{位元數 (Bits)}}{8} ight) imes 1.25 ext{ (KV Cache 與系統預留)}$$
| Llama 模型類型 | 建議量化/精度 | 最低 VRAM 需求 | 推薦 GPU 配置 | 建議系統 RAM |
| Llama 3.2 (1B - 3B) | FP16 / INT8 | 4 GB - 8 GB | RTX 4060 / 3060 | 16 GB DDR4/DDR5 |
| Llama 3.1 (8B) | Q4_K_M (輕量) / FP16 | 6 GB (Q4) / 18 GB (FP16) | RTX 4070 Ti Super (16GB) | 32 GB DDR5 |
| Llama 3.3 (70B) | Q4_K_M (日常推理) | 40 GB - 48 GB | 2× RTX 4090 (48GB) 或 2× RTX 6000 Ada | 64 GB - 128 GB DDR5 |
| Llama 3.3 (70B) | FP16 (全精度推理/微調) | 140 GB+ | 4× RTX 4090 / 2× A100 (80GB) | 128 GB+ DDR5/ECC |
2. 硬體選型指南
GPU(顯示卡)— 最關鍵組件
-
NVIDIA 優先:Meta Llama 針對 NVIDIA CUDA 及 TensorRT 進行深度優化,支援 FlashAttention-2,推理與微調效率最高。
-
顯存容量 > 單卡算力:如果顯存不足,模型需 Offload(卸載)到 RAM 運算,速度會下跌 10 倍以上。
-
多卡構建:運行 70B 模型時,建議採用 PCIe 4.0/5.0 x8+x8 以上的主機板,並選用風冷雙槽或水冷顯示卡以保持散熱通暢。
CPU(中央處理器)
-
通道數與 PCIe 版本:多卡環境下,CPU 需提供足夠的 PCIe Lanes(PCIe 5.0/4.0)。
-
單核效能:影響 Token 預處理與 Prompt 解析速度。建議 AMD Ryzen 9 7900X / Intel Core i7-14700K 或更高;多卡伺服器建議選用 AMD Threadripper。
RAM(系統記憶體)
-
記憶體容量必須大於所載入模型檔案的 1.5 倍(作為 CPU 備用與快取)。
-
選用高頻率 DDR5(5600MHz - 6000MHz),高頻寬有助於 CPU-GPU 之間的數據傳輸。
Storage(儲存空間)
-
Llama 70B 未壓縮模型檔案約 140GB,Q4 量化版約 40GB。
-
建議配備 2TB 或以上的 PCIe 4.0 M.2 NVMe SSD(讀取速度 $ge 7000 ext{ MB/s}$),確保模型載入時間縮短至數秒內。
火牛(電源供應器)與散熱
-
單卡 RTX 4090 配置:建議 1000W(ATX 3.0 標準)。
-
雙卡 RTX 4090 配置:建議 1600W - 2000W 額定電源,配備獨立 15A 供電線路。
3. 可執行的 AI 應用參考例子
砌妥 Llama 本地 AI 電腦後,可直接運行以下私有化應用:
-
企業/個人私有化知識庫 (RAG)
-
工具:Dify, AnythingLLM, Open-WebUI
-
用途:將公司的 PDF、Word、Excel 文件匯入,讓 Llama 3.3 (70B) 在完全斷網的環境下檢索並回答業務問題,確保數據零洩漏。
-
-
本地 Code Copilot(程式碼生成助手)
-
工具:Continue.dev 插件 + VS Code / JetBrains
-
用途:利用 Llama 3.1 8B/70B 進行即時代碼補全、Refactor(重構)及 Code Review。
-
-
自動化 AI Agent 流程
-
工具:AutoGen, CrewAI, LangChain
-
用途:設定多個 Llama Agent 扮演不同角色(如:市場分析師、文案撰寫員、數據校對員),自動完成複雜的多步驟任務。
-
專業 AI 砌機服務推薦
構建高效能的 Meta Llama AI 工作站,涉及複雜的多卡 PCIe 頻寬配置、散熱通道規劃以及 ATX 3.0 高功率供電平衡。
特別推介:「HKAIPC 香港AI电脑砌机专门店」
作為香港領先的 AI 硬體方案專家,HKAIPC 提供一站式 AI 電腦砌機與部署服務:
-
專業規格匹配:根據你的 Llama 模型使用場景(8B 微調 / 70B 推理 / 多卡 RAG 系統),量身訂造最佳效能價格比的硬體組合。
-
軟硬體整合調校:出廠前預先安裝及優化 CUDA、PyTorch、Ollama、Open-WebUI 等 AI 運行環境,開機即用。
-
高負載穩定性測試:嚴格進行雙烤與長時間 LLM 全負載推演測試,確保顯示卡與電源在 24/7 運作下穩定散熱。
不論是個人開發者、研究機構或企業本地化 AI 部署,HKAIPC 香港AI电脑砌机专门店 均能為你提供最可靠的技術支援與專業建構方案。
告訴我們模型、軟件、用途及預算,我們可以按工作流整理 AI PC 配置方向。
查詢 AI 配機 →