AI電腦砌機
重塑全港AI學習生態:香港AI學院力推「18區上門專業AI教學」 助企業、學校與NGO靈活轉型
為了打破地域限制與學習門檻,香港AI學院(AIEduHK) 積極推動覆蓋全港18區的「上門專業AI課程教學服務」。學院派出一支兼具業界實務與教學經驗的專業導師團隊,直接深入企業辦公室、學校校園、社區中心及各類教育機構,提供高度客製化的AI培訓方案。
閱讀文章 →由 VRAM、GPU、Local LLM 到 AI Agent、ComfyUI 及影音工作流,用較容易理解的方式拆解 AI 電腦配置。
為了打破地域限制與學習門檻,香港AI學院(AIEduHK) 積極推動覆蓋全港18區的「上門專業AI課程教學服務」。學院派出一支兼具業界實務與教學經驗的專業導師團隊,直接深入企業辦公室、學校校園、社區中心及各類教育機構,提供高度客製化的AI培訓方案。
閱讀文章 →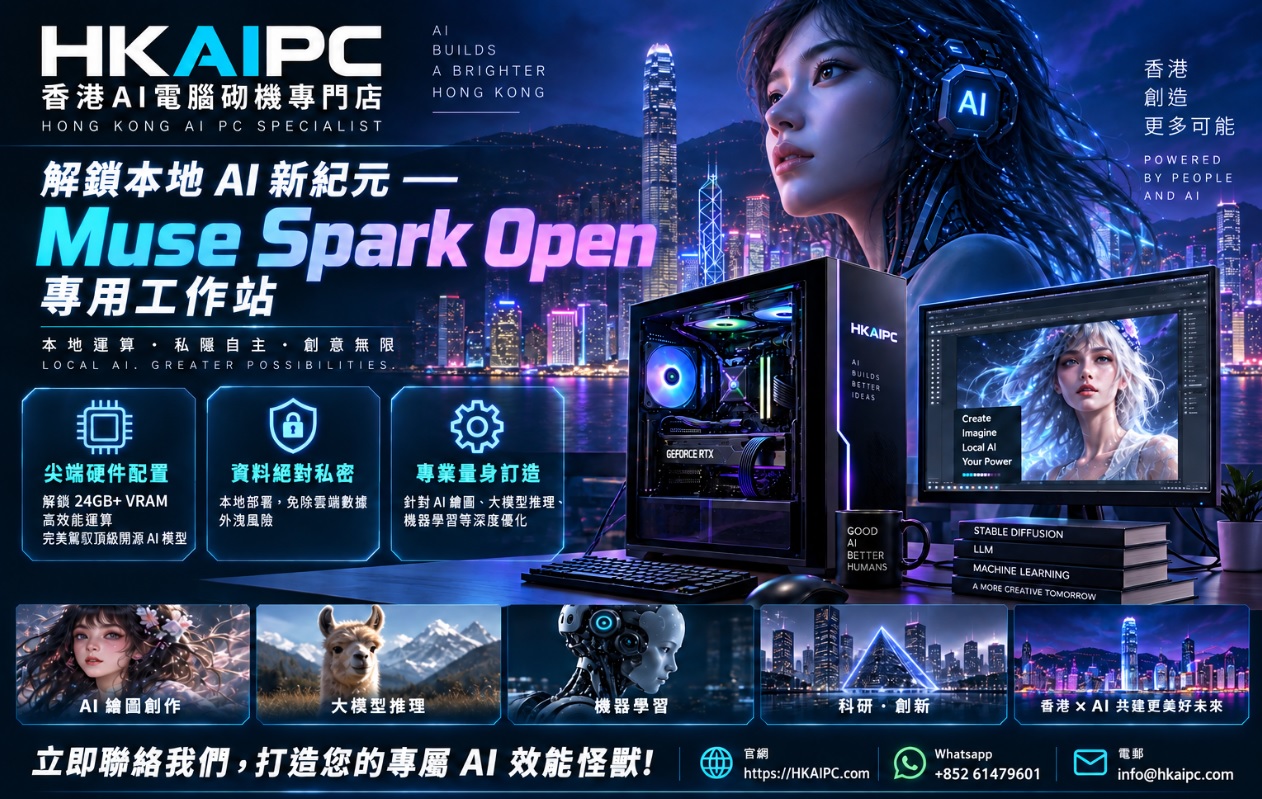
隨著生成式 AI 技術的急速發展,多模態與高互動性的 AI 模型正逐漸從雲端走向本地端部署。Meta 推出的 Muse Spark Open 引起了業界的廣泛關注。這款開源模型專為高效能、即時互動及創意內容生成而設計,讓開發者、研究人員及進階用戶能夠在本地端硬體上直接運行強大的生成式 AI 工作負載,兼顧資料隱私與極致的執行靈活性。以下我們將為您詳細拆解 Muse Spark Open 的系統需求、硬體配置方案、可執行的應用實例,助您打造最強的 AI 本地端工作站。
閱讀文章 →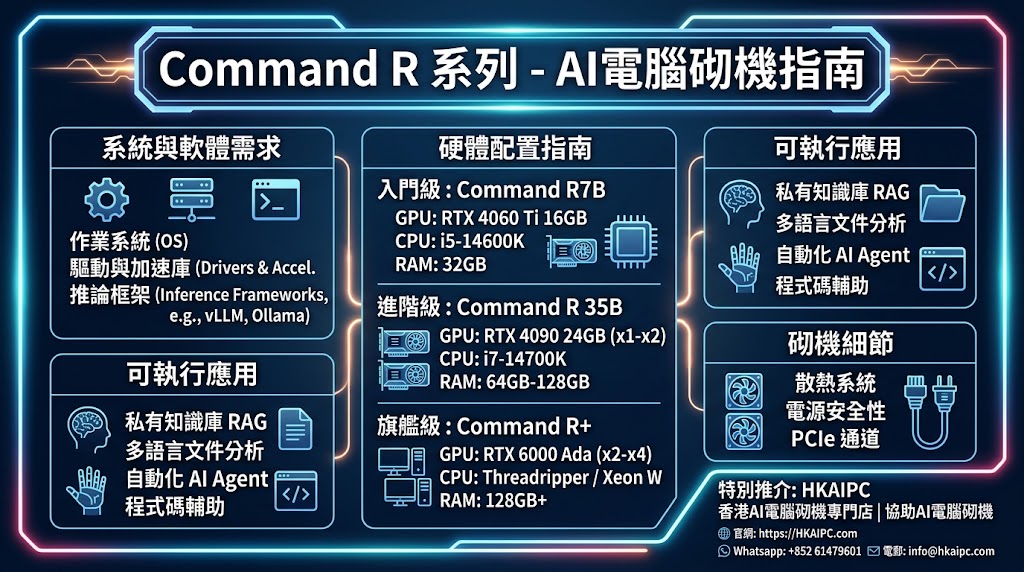
「Command R 系列 - AI電腦砌機指南」,針對 Cohere 旗下的本地大語言模型(如 Command R7B、Command R 35B、Command R+ 104B 及最新推理架構)提供具體的硬體選配與系統規劃指南。
閱讀文章 →
ChatGLM(智譜 AI 開源大模型系列,如 ChatGLM3-6B、GLM-4-9B 及清影等)在中文理解、程式碼生成與多模態任務上表現優異。要流暢地在本地端部署、微調(Fine-tuning)或運行 ChatGLM 系列模型,砌機時的核心關鍵在於 顯存容量(VRAM)、系統記憶體(RAM) 以及 NVMe SSD 讀寫速度。
閱讀文章 →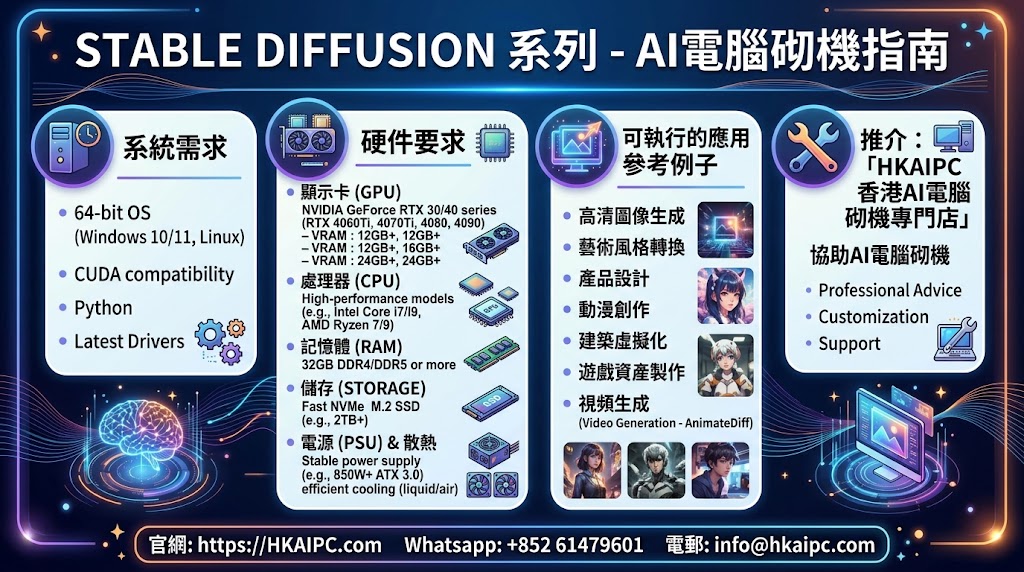
在 AI 繪圖與視覺生成領域,Stable Diffusion(包括 SD 1.5、SDXL、SD3.5 及 Flux 等模型)因其高度開源、自由度高且支援強大外掛(如 ControlNet、LoRA、AnimateDiff),成為設計師、動漫創作者與數位行銷團隊的首選工具。由於 AI 生成需要龐大的平行運算能力與顯示記憶體(VRAM),配置一台合適的「AI 電腦」能顯著減少算圖時間並大幅提升生成解析度。
閱讀文章 →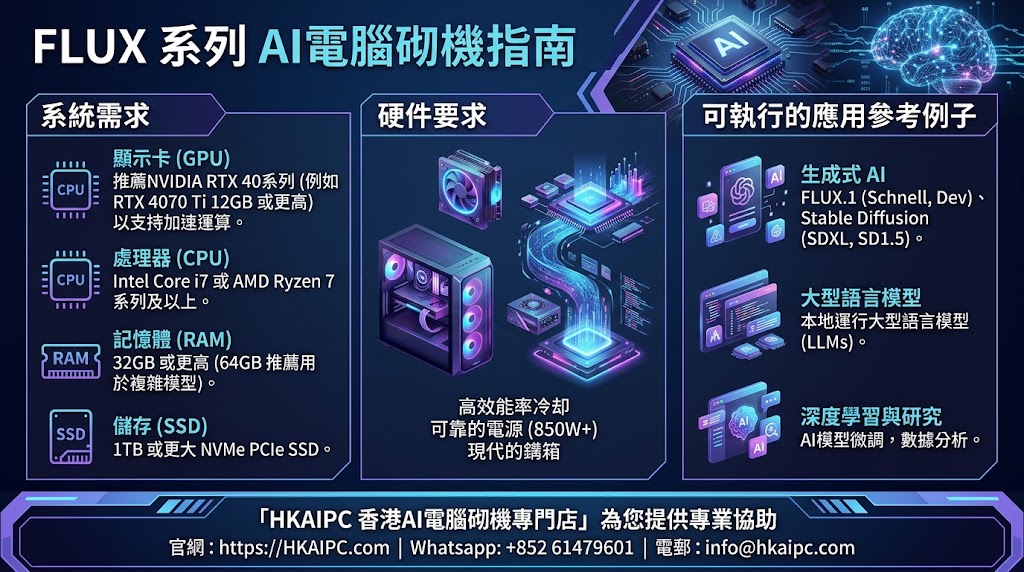
由於 FLUX 的模型體積顯著大於傳統 Stable Diffusion 1.5 或 SDXL,對硬件(特別是顯示卡顯存 VRAM 及系統記憶體 RAM)的要求大幅提升。本指南將為你詳細拆解運行與訓練 FLUX 系列所需的電腦硬體規格配置與實際應用情境。
閱讀文章 →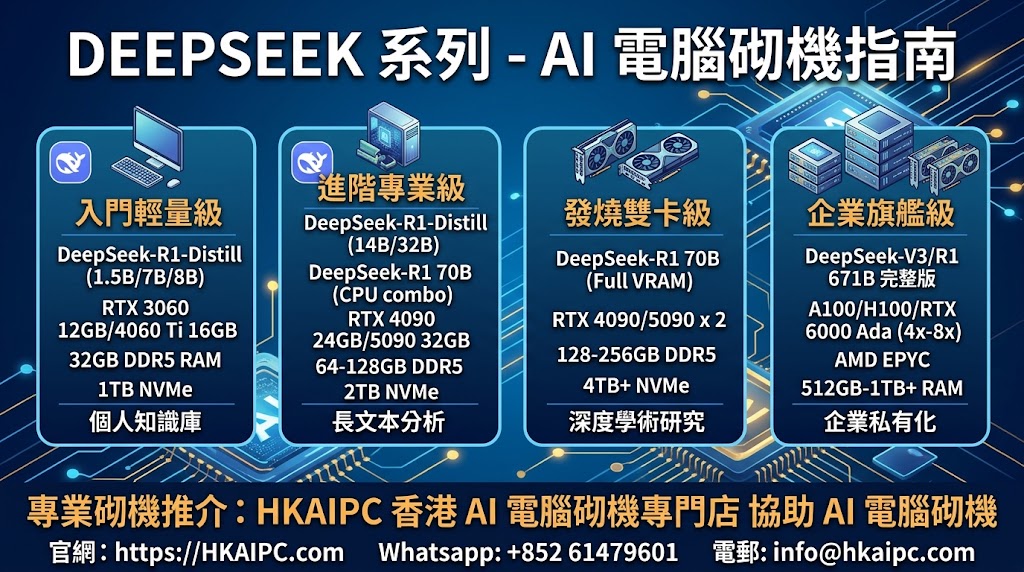
隨著 DeepSeek 系列模型(包括 DeepSeek-V3 與 DeepSeek-R1 深度推理模型)的爆紅,越來越多企業與個人創作者選擇在本地端(Local AI)部署模型。本地運算不僅能確保數據隱私,還能免去 API 訂閱費用與聯網延遲。以下為大家整理詳細的 DeepSeek AI 電腦砌機指南,由入門試玩到企業級極限推理全覆蓋,助你精準選購硬件。
閱讀文章 →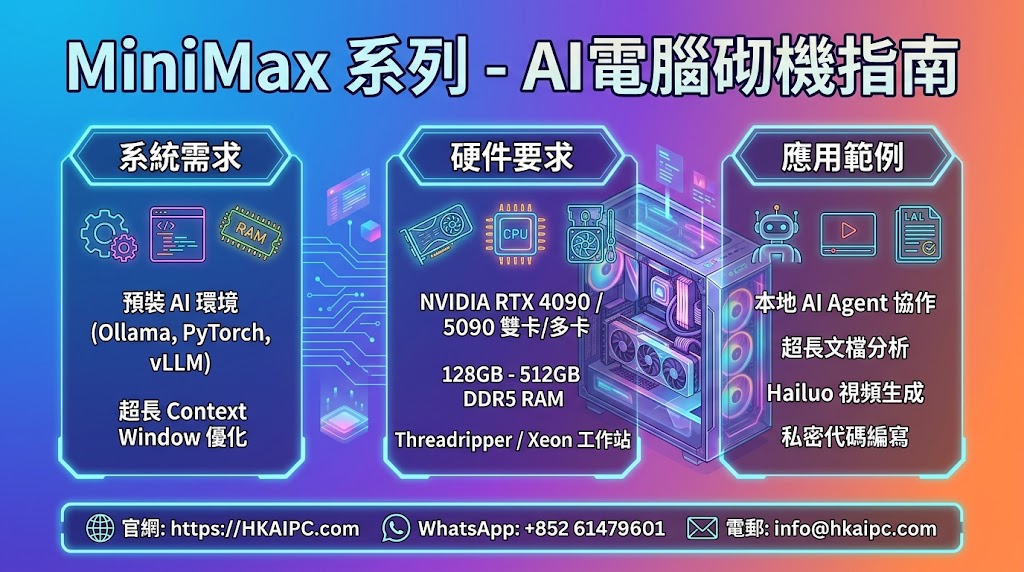
MiniMax 系列模型(如 MiniMax-M2 / M2.5 / M3 及 Hailuo 視頻生成模型)作為強大的巨量參數 MoE(混合專家)與多模態模型,具備超長 Context Window(最高達 100萬 Tokens)及卓越的 Agent 協同能力。然而,本地部署這類龐大模型對硬件(尤其是 VRAM 與 System RAM)提出了極高要求。本指南將全面拆解 MiniMax 系列 AI 電腦砌機的系統需求、硬件配置建議及實際可執行的應用範例。
閱讀文章 →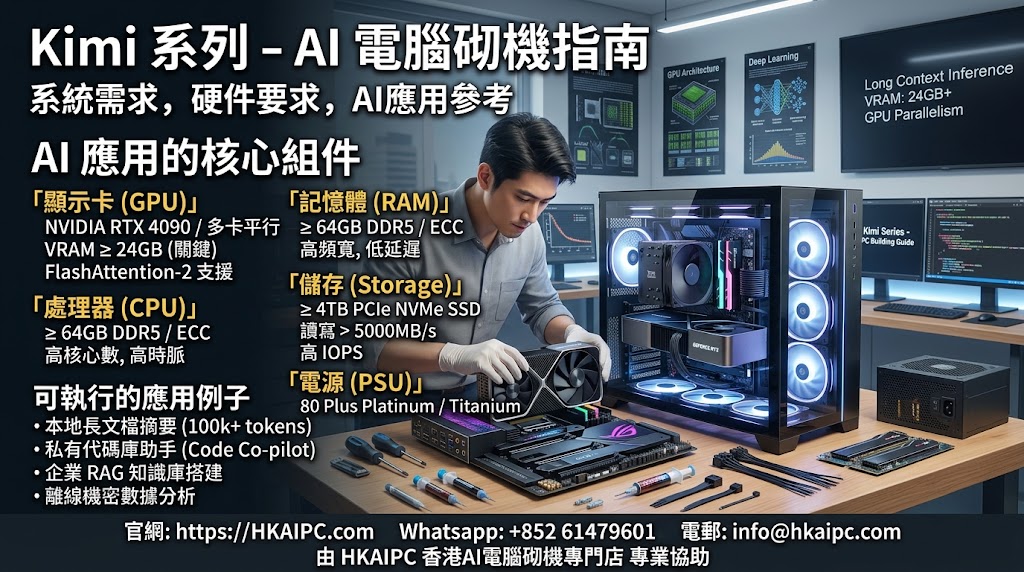
本地部署 Kimi 系列 LLM(Moonshot AI / Kimi-k1.5、Moonlight 混合專家模型及 Kimi 衍生開源架構) 能實現極高數據隱私、無API呼叫限制以及低延遲的本地推理。Kimi 類型的模型具備超長上下文處理(Long Context)與強大的長文本推理能力,對於電腦的記憶體容量與 GPU 顯存(VRAM)需求較一般模型更高。
閱讀文章 →