AI電腦砌機教學課程
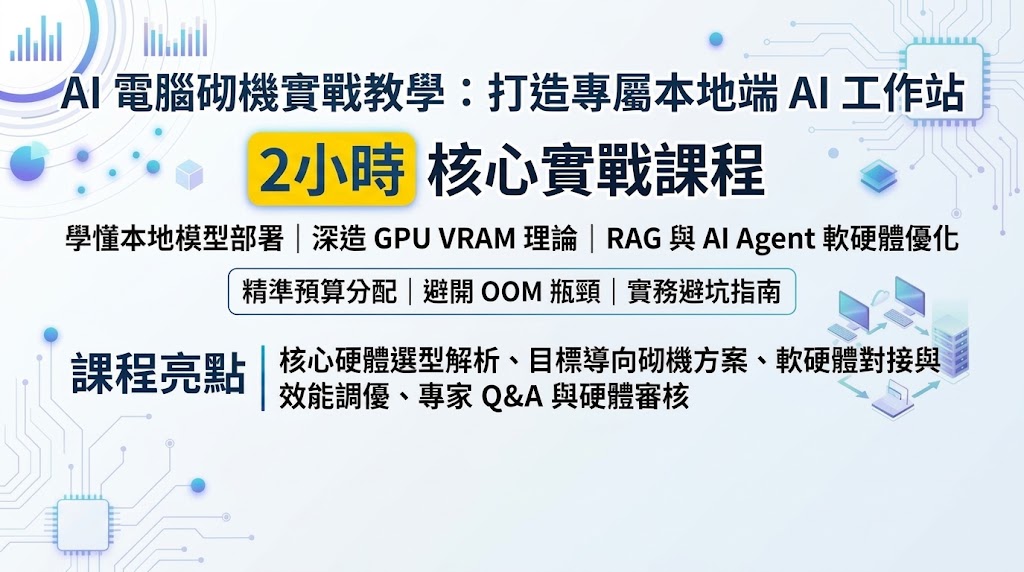
學習兩小時 AI 電腦砌機與本地端模型部署課程!深入解析 GPU VRAM 選型、CUDA 架構及記憶體瓶頸,輕鬆私有化運行 DeepSeek、Qwen 及 AI Agent 框架。精準分配預算,打造高性價比 AI 工作站!
課程總時數
2 小時(高密度核心實戰)
授課模式
理論解析、硬體規格匹配及軟硬體協同實戰
適合對象
AI 開發者、數據分析師、注重數據私隱的企業主管與電腦裝機發燒友
學習目標
掌握 AI 硬體選型、避開 VRAM 瓶頸,流暢運行本地 LLM 與多智能體架構
課程簡介
隨著雲端 AI 服務訂閱費用上升、API 呼叫延遲以及企業敏感資料私隱風險的增加,私有化部署本地端大語言模型與自主 AI Agent 已成為現代技術開發者與企業升級轉型的核心趨勢。然而,傳統遊戲電腦或一般辦公工作站的組裝邏輯,並無法滿足本地 AI 運算的特殊需求。
AI 運算的效能瓶頸往往不在於 CPU 速度,而取決於顯示記憶體(VRAM)容量、記憶體頻寬、CUDA 架構支援以及 NVMe 高速讀寫吞吐量。若硬體配置不當,容易出現記憶體溢出(OOM)、推理速度緩慢或長文本檢索失真等問題。
本課程專為希望建立私有 AI 運算環境的人員設計,用精準的 2 小時時間,帶領學員全面破解 AI 硬體選型密碼。內容涵蓋從硬體零組件(GPU、RAM、CPU、SSD、電源與散熱)的精準匹配,到本地端主流模型(如 DeepSeek-R1、Qwen 2.5、Llama 3.3)與 AI Agent 框架(如 Dify、Ollama、ComfyUI)的軟硬體協調調優。學員將學會如何以最高性價比砌出滿足需求的 AI 專用電腦,隨時調用私有模型與自動化工作流。
課程核心亮點
- 精準預算分配: 突破傳統砌機迷思,將 60% 以上預算集中於核心運算單元,避免資源浪費。
- 量化技術與硬體對算: 深入理解 FP16、INT8、INT4 等量化模型對 VRAM 的真實佔用量,算出精準的需求清單。
- Agent 多微服務架構相容: 針對同時運行 Docker、向量資料庫(Vector Database)與推理引擎的多工作業進行硬體優化。
- 實務避坑指南: 分析多卡並行(Multi-GPU)的 PCIe 通道限制、電源瞬間峰值功耗與長時高負載散熱解決方案。
詳細課程大綱
第 1 段落:00:00 - 00:40(共 40 分鐘)
第一單元:AI 運算底層邏輯與核心硬體規格拆解
本單元建立學員對本地端 AI 運算硬體需求的正確認知,解析各零組件在推理與微調過程中的影響力。
- VRAM 顯示記憶體決定論: 剖析 VRAM 容量與模型參數規模(7B、14B、32B、70B)及上下文窗口(Context Window)長度的直接關聯。
- 顯示卡(GPU)生態選擇: NVIDIA CUDA 與 Tensor Cores 的壟斷性優勢;不同卡別(如 RTX 3090、4070 Ti Super、4090 及工作站卡)的 VRAM 頻寬與推理速度對比。
- 系統記憶體(RAM)的後備機制: 處理大文本 RAG 檢索與多容器 Docker 時的記憶體需求,DDR5 高頻寬對 CPU 模式推理的補償效益。
- 儲存與架構支援: NVMe PCIe 4.0/5.0 SSD 讀取速度對快速載入大模型檔(GGUF / Safetensors)的重要性;CPU 的 AVX2/AVX-512 指令集支援需求。
第 2 段落:00:40 - 01:20(共 40 分鐘)
第二單元:目標導向——AI 模型與 AI Agent 砌機方案配置
結合實務應用場景,針對不同級別的本地 AI 任務,設計精準的硬體清單與組裝注意事項。
- 場景一:個人輕量開發與日常助理(7B-8B 模型)
目標執行 Ollama + Llama 3 / Qwen 7B。主打入門普及型配置,著重性價比與基礎 12GB/16GB VRAM 選型。 - 場景二:深度邏輯推理與多模態創作(14B-32B 模型 / SDXL / ComfyUI)
目標運行 DeepSeek-R1 32B 量化版及高解析度 AI 繪圖。配置 16GB-24GB 單卡,配合 64GB DDR5 記憶體與 2TB 高速 SSD。 - 場景三:私有化 AI Agent 自動化工作流(Dify + Docker + 向量資料庫)
分析 AI Agent 運行時的多微服務架構資源佔用,解決 CPU 多執行緒調度與多任務併發的記憶體瓶頸。 - 組裝實務與功耗控制: 80 PLUS 金牌/白金火牛選擇、多卡空間規劃、水冷與風冷散熱配置及系統防降頻設定。
第 3 段落:01:20 - 02:00(共 40 分鐘)
第三單元:軟硬體對接部署實戰與效能調優
將組裝好的硬體與本地端 AI 執行環境接軌,確保系統發揮 100% 應有的算力輸出。
- 底層驅動與加速環境佈署: CUDA Toolkit、cuDNN 基礎套件配置與驅動程式版本選擇重點。
- 本地推理框架實戰: 安裝與配置 Ollama、LM Studio、vLLM,了解如何調整 GPU 層數加載(GPU Offloading)以達到最佳吞吐量。
- AI Agent 平台快速搭建: 利用 Docker 部署 Dify 框架,串接本地 Ollama 模型,建構私有知識庫問答 Agent。
- 系統壓力測試與調優: 使用檢測工具監控 GPU 溫度、VRAM 佔用率與 Watt 功耗,優化系統長時運作穩定度。
常見問題 (FAQ)
Q1:我想在本地運行 32B 或 70B 的大語言模型,顯示卡 VRAM 至少需要多少?
A1:運行模型所需的 VRAM 取決於模型參數與量化精度(Quantization)。一般而言,每 10 億(1B)參數在 INT4 量化下約需 0.8GB 至 1GB VRAM。運行 32B 模型建議至少具備 16GB 至 24GB VRAM(如 RTX 4070 Ti Super 16GB 或 RTX 3090/4090 24GB);若要流暢運行 70B 模型,則建議採用雙卡並行(如雙 RTX 3090/4090 共 48GB VRAM)或利用系統 RAM 進行部分分流。
Q2:為什麼 AI 電腦通常優先選擇 NVIDIA 顯示卡,而較少選擇 AMD 或 Intel?
A2:因為目前絕大多數開源 AI 框架(如 PyTorch、Ollama、vLLM、Dify 等)都是基於 NVIDIA 的 CUDA 架構進行原生開發與優化。NVIDIA 顯示卡具備專用的 Tensor Cores 矩陣運算單元,在生態相容性、調優工具以及推理速度上均具有顯著優勢,能大幅減少部署時遭遇的軟體相容性障礙。
Q3:如果預算有限,可以使用一般二手顯示卡(如 RTX 3090 24GB)來砌 AI 電腦嗎?需要注意什麼?
A3:RTX 3090 24GB 是目前本地 AI 開發者中非常受歡迎的高性價比選擇,因為它提供了高達 24GB 的大 VRAM 與高記憶體頻寬。但選擇二手卡時需特別注意:顯示卡過往是否經歷長期高溫算礦負載、散熱墊與風扇狀態、電源供應器(火牛)建議配備 850W 以上,以及機箱是否有良好的風道設計以應對其 350W 的高發熱量。
Q4:部署 AI Agent(例如 Dify)對電腦硬體的要求,與單純運行對話模型有何不同?
A4:單純運行對話模型主要消耗 GPU 的 VRAM 與算力;而 AI Agent 系統通常採用微服務架構(包含 Web 介面、數據庫、向量數據庫、Redis 快取與 API 工作流),這會同時佔用較多的系統記憶體(RAM 建議 32GB 或以上)與 CPU 多核運算能力。因此,AI Agent 砌機方案需要更平衡的系統記憶體與儲存讀寫速度。